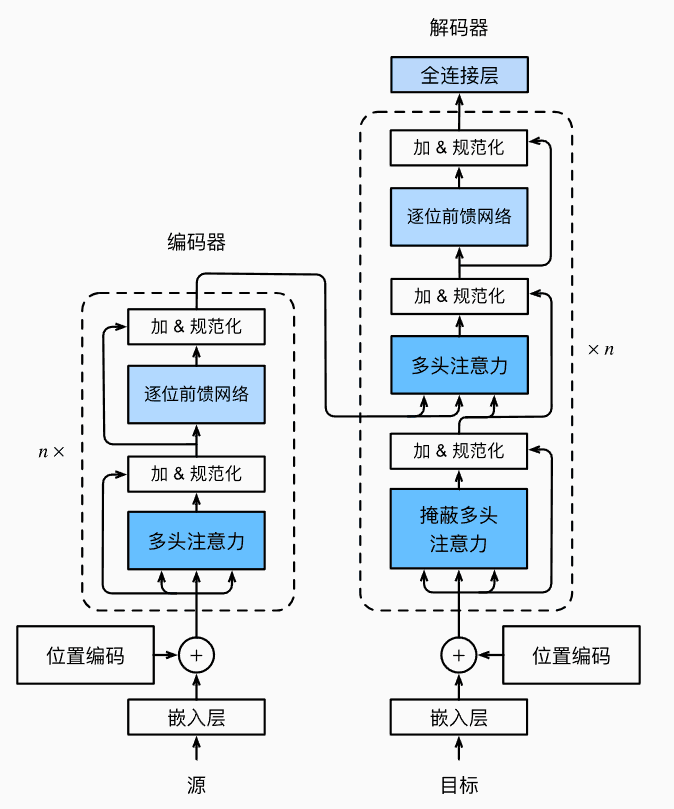
Transformer模型的核心是编码器-解码器(Encoder-Decoder)架构,但与传统的序列到序列模型不同,它完全放弃了循环和卷积结构。
-
编码器(Encoder):负责处理输入序列,将其编码成一个连续的向量表示。它由一系列相同的编码器层堆叠而成,每个编码器层包含两个子层:
- 多头自注意力机制
- 前馈神经网络
-
解码器(Decoder):负责根据编码器的输出生成目标序列。它也由一系列相同的解码器层堆叠而成,每个解码器层包含三个子层:
- 带掩码的多头自注意力机制
- 交叉注意力机制
- 前馈神经网络
1. input & output
输入:
- 输入一段text ,每个词视为一个token,经过Embedding(词嵌入),每个token都转为稠密向量如32维 ->(batch,seqlen,32)
torch.nn.Embedding(num_embeddings, embedding_dim)本质上是一个查找表矩阵,token作为index,返回一行向量,随机初始化然后通过优化器优化表示- (上述的嵌入维度也称 )
- 位置编码:RoPE (Rotary PositionEmbedding)
- 用于补充位置信息(注意力机制本身是顺序无关),编码方法本身可以随意,论文中使用的方法是正余弦函数交替,同样生成(batch,seqlen,32)
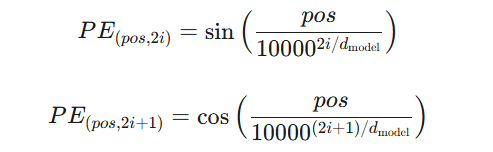
- pos 是词语在序列中的位置(比如0、1、2...)
- dmodel 是词嵌入向量的维度即embedding_dim - (对于dim为32的嵌入,会遍历i从0-15生成一个32维的位置编码向量,然后直接与word vector相加)
为什么用RoPE? - 正余弦分解后,pos+k位置可用pos与k位置线性组合表示,包含相对位置信息*
解码: - 输出一般是一个(batch,seqlen,vocab_size)
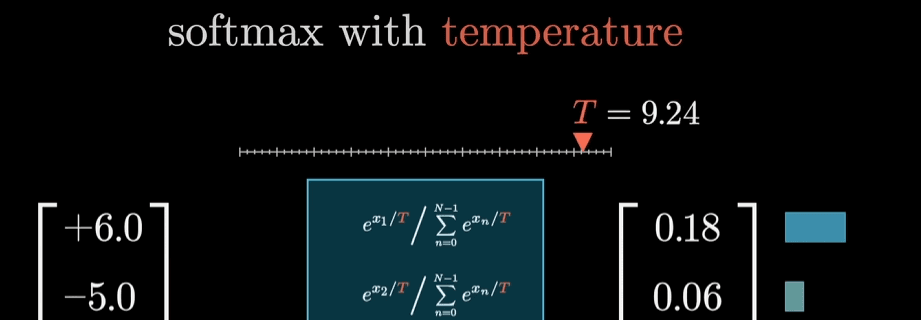
- 最后一部分是logits向量,通过softmax转为概率分布probilities
- 此处softmax变种,引入T(温度系数)来调整输出权重,T越高,将增加低概率token的权重,最终根据概率进行随机选择
2. Attention
为输入序列中的每个元素计算一个注意力分数,这些分数代表了该元素对当前任务的重要性。然后,模型使用这些分数对所有元素进行加权求和,从而得到一个包含上下文信息的向量表示。
查询(Query, Q)、键(Key, K)和值(Value, V)
注意力分数:
- => score(Q,K) = Q·
- 具体来讲,每个词都会有一个 和
- 让一个词的 去查询另一个词 其点积越大,表示这两个词之间的关系越值得注意
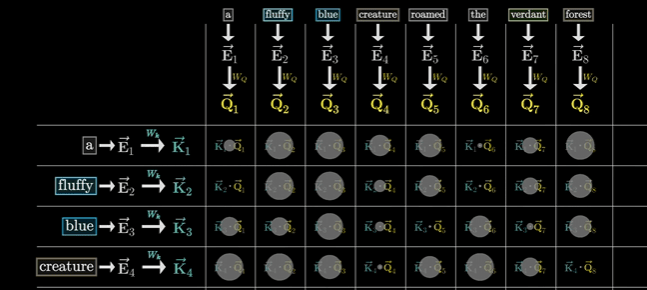
- 为了防止点积结果过大导致梯度消失,通常需要对分数进行缩放然后转为一个概率分布,表示各词在序列中的重要程度:
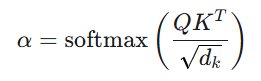
- 其中 为 的维度, 一般为
- 比如512维嵌入,8注意力头,则取64
- 注意力分数维度 Q (seqlen,) · (,seqlen) => (seqlen,seqlen)
掩码:
- 在softmax之前,Q· 矩阵左下角部分 设置为
- 这样在softmax之后,左下角都会变成 0,每个词对于该词之后的注意力分数都会变为 0,这样就无法看见未来的内容导致信息泄露
- (根据任务而定,有些任务不用掩码)
上下文表示: ·
- => Attention = · ( )
- shape:(seqlen,d_k)
- Multihead => n_head contact => (seqlen,d_model)
- 也即:
如何获得QKV?- Q = X·
- K = X·
- V = X·
- 其中, 都是随机初始化然后经过优化器学习而得的权重矩阵,维度都为(,)
3.多头注意力
注意,对于多头注意力,三个权重矩阵是对于整体而言的
- X (seqlen,d_model) (d_model,d_model)
- Q => (seqlen,d_model)
计算完QKV后,计算注意力分数之前,进行拆分: - 单头 => Q (seqlen,d_k)
多头的输出: - 每个头的Attention(seqlen,d_k)拼接后再经过一个全连接层,变成(seqlen,d_model)
输出:
残差连接:Mulhead输出再和X相加 - LayerNorm:对单个样本的所有特征维度进行归一化
- [[FFN]]:对每个位置的向量进行独立的、非线性的变换
- 之后再加残差和LayerNorm,作为输出
4.交叉注意力
这部分涉及 解码器 的设计:
- 解码器自注意MulHead的输入:
- 目标序列,模型看到的当前词和上下文(带掩码,表示只能看到当前和之前的内容)
- (batch,seqlen,d_model)
- 训练时,这个seqlen就是整个序列的长度
- 推理时,这个seqlen会随着自回归的过程增大 1,2,...,
- 交叉注意力CrossHead的输入:
- Q: X来自解码器的前一个子层X · (查询目标)
- K、V: X来自encoder的输出X · , X · (序列特征)
5.叠加
编码器块和解码器块都可以叠加更多的块以提高表现
编码器块:
- 按顺序堆叠。第一个编码器块接收原始输入(词嵌入 + 位置编码),其输出作为第二个编码器块的输入,以此类推。
解码器块: - 也按顺序堆叠。每个解码器块的输入来自前一个解码器块的输出,而其交叉注意力机制的输入则始终来自最后一个编码器块的输出。
6. 对比
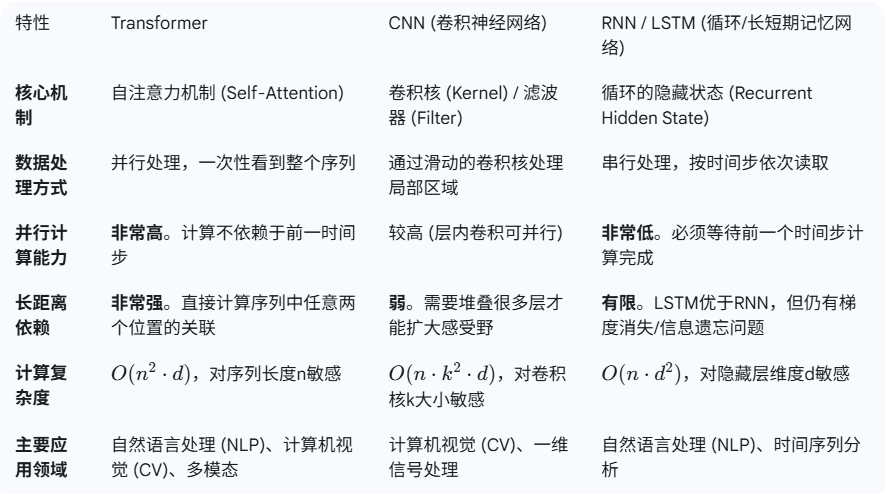
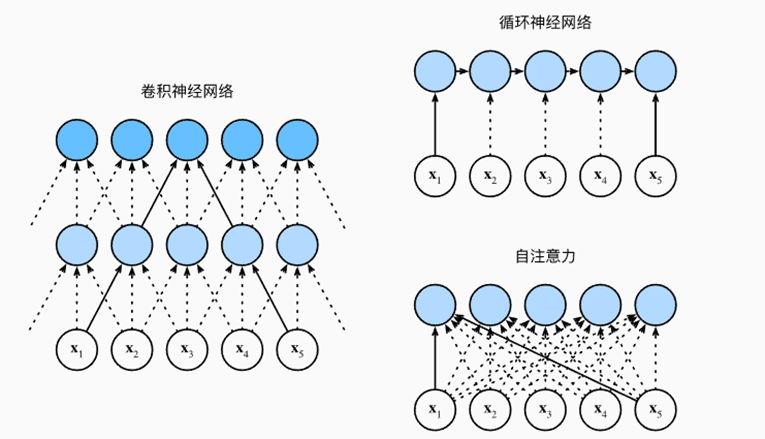
Transformer 的主要优势在于其通过自注意力(Self-Attention)机制,实现了卓越的并行计算能力和更强大的长距离依赖(Long-Range Dependencies)捕捉能力。 这使其在处理长序列(如长篇文章、基因序列等)时,效果和效率都远超传统的 RNN/LSTM